标签归档:DeepSeek

DeepSeek Harness 的 Cordis 插件架构

DeepSeek Harness 把模型、工具、会话、沙箱、文件系统、Agent 循环、调度和 UI 都交给插件。

系统没有一块承载业务能力的固定内核,Cordis 只维护上下文、服务注册、事件分发、依赖激活和副作用回收;Agent 能做什么,由启动时挂入的一棵插件树决定。

传统的插件有注册容易,撤销困难;初始化容易,失败回滚困难;全局单例容易,局部覆盖困难等问题,而 Cordis 把这些困难收进了运行时语义,Harness 再用 session、agent 和 preset 的业务约束补齐它。

今天聊了一下 DeepSeek Harness 的核心 Cordis 架构以及 Cordis 所谓「时空可组合」,究竟怎样落到代码里,又为何适合 Agent Harness 这类持续变化的运行时。

插件的历史

插件架构的历史并不短。Eclipse 在二十多年前已经把 IDE 拆成插件、扩展点和扩展,宿主声明可扩展位置,其他插件通过清单贡献菜单、编辑器和处理逻辑。

OSGi 更进一步,给 bundle 配置安装、启动、停止、更新和卸载生命周期,再通过共享服务注册表完成发布、查找和绑定。服务离开注册表时,依赖方必须跟着处理动态变化。

今天看 Cordis,能找到这些设计的清晰痕迹:动态服务、生命周期、注册表、声明式依赖、事件通知都已有成熟先例。

Cordis 没有发明插件系统。

它简化并重新组合了这些概念,让它们适合 TypeScript 应用内的细粒度组装。OSGi 的部署单元是 bundle,模块、生命周期、服务和安全各有一层;Cordis 的执行单元是 Fiber,一个函数或一个 Service 子类就能成为插件。Eclipse 的扩展点通常由宿主定义结构化清单,Cordis 让服务和类型化事件直接成为扩展面。Agent 运行时里的工具、提示词片段、模型适配器和审批策略变化频繁,如果每次扩展都要引入重量级模块边界,团队很快会绕过框架,重新写回几个全局数组。

Cordis 官方仓库把自己定位为「Meta-Framework of Spatiotemporal Composability」。

从源码看,「元框架」表示它不规定 Agent、Web 服务或机器人该有什么组件,只提供构造框架所需的基础语义。DeepSeek Harness 在其上定义 sessions、tools、llm、agents 等服务,又用这些服务组装产品。Cordis 与 Harness 的关系更接近运行时机制和领域框架,而非通用插件平台与插件集合。

DeepSeek Harness 还把 Cordis 源码直接放进 vendor/,固定在明确的上游提交,并将包名重映射到 @deepseek-ai 命名空间。

项目维护的本地修改包含 Fiber 重入卸载加固、配置更新事务、HMR 精确监听、延迟配置解析等。这增加了维护成本,也换来了框架层的可审计性。Agent 能执行 Shell、修改文件、访问网络,插件生命周期出错会留下进程、监听器、终端模式或权限状态。

此时依赖一个本地的代码白盒,会让人放心一些。

调用链路图

简单的调用图如下所示:
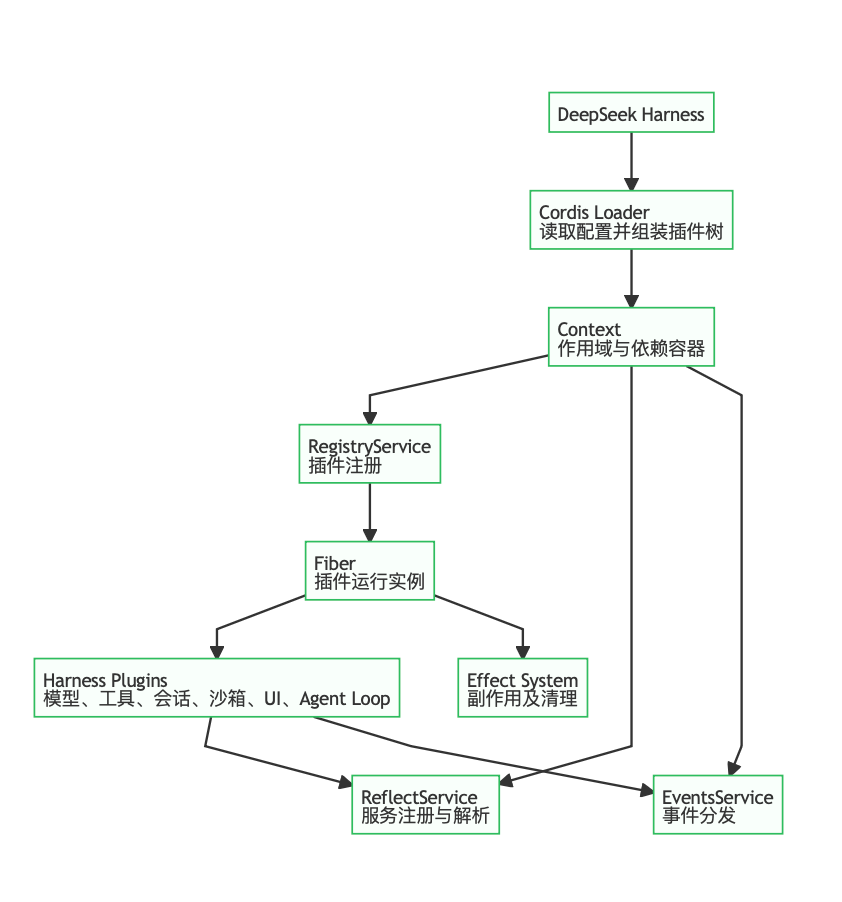
最小内核

Cordis 的根对象是 Context。它同时承担依赖容器、插件挂载入口和事件入口。

服务通过稳定名称出现在 ctx 上,例如 ctx.tools、ctx.llm、ctx.sessions。插件声明 inject 后,Cordis 只有在所需服务可用时才激活它;服务消失,依赖插件也会进入卸载或等待状态。配置文件中条目的先后顺序因此不承担启动顺序,依赖关系才承担。

这种处理解决了传统插件系统的第一个顽疾:隐含初始化顺序。

常见实现会遍历插件数组,依次调用 init。当工具依赖文件系统、文件系统依赖沙箱、UI 又依赖会话时,数组顺序就变成一套没有类型、没有诊断的依赖图。后来插入一个插件,顺序约束可能跨越几十个文件。

Cordis 把需求写进 inject,Fiber 会为每项依赖保存当前实现;缺少依赖时保持 PENDING,依赖齐备后进入 LOADING 和 ACTIVE。启动失败则进入 FAILED。状态机至少让故障有了准确位置。

Context 还是一个代理对象。

插件直接读取 ctx.tools 时,反射层会检查它是否声明过依赖,并沿 Fiber 父链解析实现。未声明就读取会抛错;声明了但当前上下文不可用,也会抛出另一类错误。这种约束防止依赖藏在任意函数深处。源码里依然提供 ctx.get(name) 读取可选服务,区别在于调用方显式接受服务可能不存在。

这里的「服务定义、服务提供方、消费方」三种角色被完整建模。比如文件系统能力不能只写一个接口,也不能只挂一个本地实现。定义方稳定调用协议,提供方接入本地目录或远程沙箱,消费方把能力变成模型可见工具。Harness 把这组关系称为 capability seam。替换沙箱时,Shell、PTY、LSP 只要依赖同一能力面,就能整体迁移到新的执行环境,消费方无需知道提供方运行在本机还是远端。

「一切皆插件」有一个前提是:一切产品能力皆由插件贡献,Cordis 自身仍保留插件得以存在的机制。上下文代理、Fiber 状态机、服务存储、事件总线和 Loader 属于元层。

这并不是系统里没有内核,更准确的说,应该是,内核不拥有模型、工具和循环等产品特权。

空间组合

同一个进程里,服务名称必须稳定,实例又不能全局唯一。两个 Agent 可能选择不同模型、不同工具集、不同 persona 和不同沙箱。如果 ctx.llm 永远指向一个全局对象,插件替换只发生在进程级,无法满足多会话并存。

Cordis 的 Context.isolate 为指定服务名创建一个 realm 标签。服务注册和查找都以该标签定位,同名服务可以在不同子上下文里各自存在。两个 isolate 调用传入同一标签时会加入同一 realm;使用新标签时彼此隔离。子上下文通过原型继承父上下文,隔离映射按层遮蔽,因此局部配置不需要复制整棵容器。

这解释了「空间可组合」的第一层:组合具有位置。插件挂在哪个上下文,决定它提供的服务、注册的监听器和持有的副作用在哪个范围可见。传统依赖注入容器也有 singleton、request、session 等 scope,Cordis 的差异在于作用域与插件树、事件过滤、资源所有权使用同一个 Context 表达。开发者无需在四套 API 之间同步身份。

DeepSeek Harness 又增加了 dsh-scope。它用不透明对象作为 scope key,维护父子关系,并创建带路由身份的事件 receiver。注册视图沿父链向下继承:Agent 能看到所属 preset 的提示词和工具。事件则沿链向上接纳:preset 级监听器能收到其下 Agent 的事件,兄弟 Agent 互不串线。这是第二层空间结构,解决的是领域身份,而非单个服务名的 realm。

为何需要两层?isolate 处理「哪个 tools 服务实例」,dsh-scope 处理「同一工具注册表里,哪些注册项对当前 Agent 可见」。前者适合替换提供方,后者适合对注册内容分层。把所有差异都做成独立服务实例,会放大内存和初始化成本;把所有差异都塞进一个全局注册表,又会让过滤规则散落在调用点。这两层模型把实例隔离和内容路由分开了。

Agent preset 是空间组合的完整应用。一个 preset 的 Cordis 配置会挂在一个长期存在的 scope 下,Agent 创建时把自己的 scope key 绑定到该 preset。相同 preset 的并发首次使用通过 single-flight 共享一次挂载,后续 Agent 复用这份组合。文件变化后,新会话加入新一代组合,已有会话保留原来的代际。这个策略避免会话运行中途突然更换工具或提示词,代价是旧代际要保留到整棵运行时退出,配置频繁变化时内存会按代际增长。

源码还专门审计 preset 子树是否把服务发布到了 root realm。发生这种泄漏时,第二个会话挂载同一 preset 会与第一个冲突,所谓会话级组合也会退化成进程全局状态。DeepSeek Harness 在发布 Agent 前拒绝这种配置。空间隔离若只靠约定,迟早会被一个没有 isolate 的 provider 穿透;运行时审计比文档警告可靠。

这套空间模型存在认知成本。插件作者要同时理解 Context 父链、服务 realm、业务 scope 父链和事件过滤方向(当然,在当前 Vibe Coding 盛行的时代,也可以作者不理解,直接让 AI 来搞)。

在认知不清楚的时候,常见的错误往往表现为某项能力「看不见」或意外泄漏,类型系统无法证明运行时挂载位置。DeepSeek Harness 用 preset 挂载审计、包级 invariant 和真实组合测试降低风险,却没有消除模型复杂度。团队若只需要单进程单 Agent,直接引入整套空间语义会显得过重。

时间组合

插件能挂载只是静态组合。运行期间服务上线、配置改变、插件失败或上下文销毁,系统还要回到一致状态。Cordis 用 Fiber 和 effect 管理这条时间轴。

每次插件应用都会产生一个 Fiber。Fiber 记录父上下文、原始配置、解析后配置、依赖实现快照、生命周期状态和 disposables。插件调用 ctx.effect() 注册副作用,effect 的执行结果返回 disposer。事件监听、服务提供、子插件和访问器最终都进入这套所有权体系。Fiber 卸载时按注册的逆序执行清理,并等待异步清理达到静止状态。

逆序本身不是一个特别要讲的事情,因为这是必须的。

若插件先启动子进程,再注册输出监听,最后暴露服务,销毁时应先撤销服务,停止新请求,再移除监听,最后结束进程。资源创建顺序的反向通常就是依赖安全的拆卸顺序。

传统插件常给出一个 deactivate() 钩子,把所有清理责任推给作者;漏掉一个定时器或事件监听,热加载几次便出现重复执行。Cordis 让每次注册同时产生撤销动作,框架持有所有权。

DeepSeek Harness 的 vendor 版本进一步处理了重入场景:effect 在执行 setup 前先登记所有者包装;插件发布事件时,观察者可能同步卸载它;异步 cleanup 已经开始后,其他调用者仍能等待同一次清理;Fiber 处于 UNLOADING 时拒绝创建新 effect。这些代码看起来全是繁琐的边界处理,但为了保证生命周期并发的安全,一个都不能少。否则插件的热卸载就只是个玩具,没法真正落地。

依赖变化也属于时间组合。某个服务被提供后,反射层通知所有声明该依赖的 Fiber 重新检查;条件满足便激活。服务撤销后,依赖方会卸载并回到等待。OSGi 早已采用动态服务注册表,Cordis 的新意主要在于把动态依赖、作用域上下文和 effect 所有权压进一个很小的进程内模型。代价同样继承自 OSGi:任何持有服务引用越过生命周期的代码,都可能在提供方撤销后继续调用过期对象。Cordis 保存加载时的实现快照,却无法替业务代码管理逃逸引用。

Loader 把时间组合延伸到配置。DeepSeek Harness 的 profile 由多层 bundle patch 叠加:基础 bundle、模式 bundle、profile patch、home patch、命令行 overlay。patch 按 id 定位条目,配置采用整块替换。整块替换要求用户重述保留字段,使用上稍显笨重,却避免深度合并规则在数组、表达式和删除语义上制造歧义。

配置热更新时,Loader 先导入候选插件,再卸载旧实例并应用候选;候选失败会恢复旧插件或旧配置。Group 对一批子条目并发启动,收集全部结果,只要一项失败就删除新增项并重建旧配置。Include 读取候选文件、在副本上应用 patch、完成树协调后才提交缓存。用户 patch 语法错误或新插件启动失败时,最后一棵可用树继续运行。

这已经接近配置事务,却不能等同于数据库事务。

插件 effect 可能调用外部 API、创建远端资源、发送消息;disposer 只能做补偿,无法保证外部世界回滚。Loader 能保证自己管理的树和服务注册恢复,无法撤回所有不可逆副作用。插件开发规范仍要限制初始化期行为,把外部写入延迟到真正的业务请求,或者设计幂等键和补偿路径。

时间组合还带来可观的测试面积。挂载成功只是第一条路径,还要覆盖依赖晚到、依赖撤销、初始化失败、卸载重入、异步清理、热更新失败、回滚再次失败。DeepSeek Harness 要求注册项证明 disposal,产品可见插件还要通过真实 Loader 组合测试。这个成本无法靠框架消失,只能被框架集中暴露。相比线上出现幽灵监听器和半更新状态,还是愿意支付这部分测试费用。

事件契约

插件之间只靠服务调用,会把所有扩展都变成接口方法。宿主每增加一项策略,就要修改服务定义。Cordis 同时提供类型化事件,并区分 emit、parallel、serial、bail 和 waterfall。

DeepSeek Harness 最依赖的是 waterfall。它的监听器拿到 next,调用后把控制权交给下一层,不调用就截断链条。模型请求、工具执行和轮次控制都能被插件包裹。审批策略可以在工具执行前拒绝,重试插件可以包围模型流,日志插件可以观察前后状态。它与 Koa 一类中间件链相似,但事件名和 Context 过滤让同一个分发器覆盖多个能力域。

waterfall 也最容易出错。一个只想记录日志的监听器忘记调用 next(),整条能力链便被短路。DeepSeek Harness 把「必须调用 next()」写进项目级规则,并在事件文档里记录 dispatch mode。类型能保证参数,却很难保证 continuation 一定执行。代码评审和组合测试仍是主要防线。

事件的持久性也被刻意分层。agent/* 和 tools/* 事件用于活跃运行时的拦截;会话事件追加到日志,承担恢复、fork、UI 回放和模型历史投影。DeepSeek Harness 规定「模型可见即已记录」:进入模型请求的输入必须能从 session log 重建。插件若偷偷修改 prompt 却不产生会话事实,重放结果会漂移,问题也无法审计。

这条约束说明,一切皆插件并不意味着一切皆事件。直接能力调用放进 Service,策略和拦截放进实时事件,需要持久化的事实进入 session log。三类通信各自承担调用、扩展和历史。将它们混成一个全局 event bus,短期代码更少,长期会失去时序语义和数据权威。

Agent 适配

Agent Harness 比普通 Web 服务更需要动态组合。模型供应商会变,工具权限随工作区变化,子 Agent 的执行环境可能与父 Agent 不同,UI 还要消费同一份流式过程。如果主循环直接 import 每个能力,任何替换都会改循环;循环逐渐成为依赖最多、风险最高的文件。

DeepSeek Harness 的默认 agent loop 仍然存在,但它也是一个服务提供方。循环读取 session log 生成历史,组装插件贡献的 prompt 和 tool schema,通过 agent/request 进入模型适配器,再经过工具流水线记录结果。扩展点围绕步骤、请求、工具和停止阶段布置。新功能通常挂到这些事件或注册表,项目规则甚至要求修改 agent loop 时同步更新架构文档。

我赞成这种限制。循环承担控制流,频繁承载产品策略后会迅速腐化。压缩上下文、重试、审批、工具超时、计划模式、子 Agent 调度都可以有自己的生命周期与配置。它们进入循环的接口必须少且稳定。插件化不会自动获得解耦,真正起作用的是 DeepSeek Harness 为能力选择了明确的 seam,并拒绝消费方特有逻辑污染定义层。

UI 作为插件也有实际意义。Web 和 headless profile 在共享 base bundle 上增加不同条目,后者可以完全不启动服务器。UI 驱动 ctx.agents,订阅 session/event 渲染状态,没必要成为循环的一部分。服务端、CLI、ACP 和浏览器界面可以共享会话及 Agent 语义,同时保留自己的传输和展示逻辑。

插件树还提供自省基础。Fiber 保留名称、状态、依赖和 effect 元数据,DeepSeek Harness 能实现查看、挂载、卸载自身插件的能力。对 Agent 而言,这比普通应用更敏感:模型可以通过工具改变运行时,错误配置可能直接扩大权限。源码中的 sandbox 和 approval 仍是独立能力,插件架构没有天然安全性。自修改必须受工具权限、配置校验和作用域审计约束。

架构代价

第一项代价是启动与运行时开销。每个插件产生 Fiber,服务访问经过 Proxy 和反射解析,事件分发要执行作用域过滤,注册项还要保存 disposer 与诊断元数据。对于 LLM Agent,单次模型请求通常以百毫秒到秒计,这些 JavaScript 调度开销很难成为主要瓶颈;高频 token chunk、文件扫描或终端字节流若全部穿过通用事件总线,成本会被放大。DeepSeek Harness 把流式模型输出定义为能力语义,但大量数据处理仍应留在具体 provider 内,事件只承载必要扩展点。

第二项代价是故障面扩大。插件初始化可以同步抛错、异步拒绝、等待缺失服务,也可能在 disposer 中失败。Group 并发启动缩短时间,却会带来多个兄弟同时失败的 AggregateError。DeepSeek Harness 的 boot 会等待 Loader 结算,审计所有启用条目是否加载与激活,失败时先 dispose 部分构造的上下文,再退出。少做任何一步,都可能让终端停留在 raw mode,或者让后台 watcher 继续运行。

第三项代价是配置成为编程接口。cordis.yml 支持 !!js 表达式,条目可以按环境禁用,配置会在依赖激活后求值。灵活性很高,静态分析能力随之下降。表达式读取服务时,求值时机与上下文位置都会影响结果。DeepSeek Harness 只允许 config 和 disabled 使用插值,其他元数据保持字面量,并让错误尽早暴露。这仍要求运维人员理解插件依赖和 patch 覆盖语义,配置文件已经超出普通 YAML 参数表的复杂度。

第四项代价是生态兼容。Cordis 的服务名和事件类型提供了源码级协议,插件版本升级仍可能修改配置、事件 payload 或生命周期假设。DeepSeek Harness 目前处于预发布阶段,仓库规则允许直接拒绝旧磁盘格式,也没有承诺 session 格式兼容。现在的可组合性主要服务于同一发行版内的替换和扩展,尚不能推导出跨版本插件 ABI 稳定。

第五项代价是组织治理。一切都能成为插件后,团队容易把每段十几行逻辑都拆成包,形成依赖图膨胀、文档分散和测试启动缓慢。DeepSeek Harness 用 package 分组、Service Definition/Provider/Consumer 角色、每包 README、运行时 invariant 和真实组合测试控制边界。这些规范本身就是成本。小团队若没有维护扩展生态或多 profile 的需求,模块化函数加显式依赖可能更合适。

历史对照

从 OSGi 看 Cordis,动态服务和生命周期联动已有先例。服务注册、发现、撤销后触发依赖变化,这条主线几乎一致。Cordis 值得学习的新点,是把资源清理统一成 effect,并让子插件、服务、监听器都归属于同一个 Fiber。OSGi 的 bundle 生命周期更完整,也更重;Cordis 选择应用内细粒度对象,失去了类加载隔离、标准版本解析和安全层,获得了低门槛组合。

从 Eclipse 看 DeepSeek Harness,profile 与 bundle patch 很像部署时组装,Service 和事件类似扩展点。差异在于 Eclipse 扩展通常围绕稳定宿主能力,DeepSeek Harness 连 agent loop 和 UI 都可替换,核心插件与第三方插件共享同一挂载机制。这个平权减少了特权内核,风险也更集中到协议治理:循环能被替换,不代表任何替代循环都遵守 session log、权限和工具时序约束。

从依赖注入容器看,Cordis 的服务解析并不陌生。新的组合来自 DI 与生命周期的绑定。普通容器负责构造对象,定时器、监听器和子进程仍由业务代码清理;Cordis 把注册动作收敛成 effect。空间 scope 与时间 ownership 同时存在,插件才能在某个 Agent 范围内挂载,并随该 Agent 完整撤销。

从微内核看,DeepSeek Harness 的内核确实很轻,但其 Loader 和配置协调已经承担不少平台职责。它要解析模块、等待依赖、处理 HMR、执行事务式更新、保存最后可用树、输出诊断。这提醒我,微内核减少的是业务特权,不会减少生命周期复杂度。能力越动态,内核对失败语义的要求越高。

Cordis 的贡献可以概括为一种紧凑的组合坐标:Context 决定插件位于哪里,Fiber 决定插件在何时有效,Service 负责直接能力,Event 负责横切协作,effect 负责撤销。DeepSeek Harness 在这个坐标系上加入 Agent scope、持久会话事件和配置事务,使其能承载多会话、多 profile 与热更新。

工程取舍

当我想要用类似架构时,会先确认三个条件,基于这三个条件判断来是否采用。

其一,能力确实需要独立替换,至少存在两个生产提供方或明确的外部扩展需求。

其二,同一进程需要多套组合并存,或者运行期间需要可靠更新。

其三,团队愿意为卸载、回滚和真实组合测试持续付费。

缺少这些条件,插件框架容易沦为复杂的工厂模式。

能力切分要从消费方开始。先列出谁调用、调用时需要哪些稳定语义,再设计 Service Definition;随后实现 provider,最后把面向模型的 schema、展示和错误文本留给 consumer。接口只有一个内部调用者时,保留私有闭包,不急着升格为公共 service。可替换性必须由真实替代者证明。

所有注册都要有明确所有者。注册工具、提示词片段、适配器、监听器时同步返回 disposer;卸载测试要观察注册项确实消失。涉及异步资源时,dispose 完成的定义要包含子进程退出、队列排空和 watcher 关闭,不能只发出取消信号。DeepSeek Harness 对 Fiber quiescence 的处理值得照搬。

配置更新要区分内存一致性和外部副作用。Loader 可以恢复旧树,插件初始化若已经创建云资源,回滚需要业务补偿。规则可更保守一些:挂载阶段只做校验和本地注册,外部写操作放到带幂等标识的运行阶段。确实要在初始化创建资源时,必须让 disposer 能识别部分完成状态。

作用域要控制在两种以内。实例隔离与注册可见性已经足够表达多数 Agent 场景,再增加租户、请求、工作区、角色四套独立 scope,调试成本会失控,需要根据实际业务需求和必要性来判断。当需要新增维度时,先判断它属于服务实例选择、注册过滤、持久数据权限还是请求参数。很多所谓新 scope,其实只是一次显式参数传递。

事件也要克制。需要唯一返回值的调用用 Service,需要持久恢复的事实写 session log,需要多个插件观察或包裹的阶段才用事件。waterfall 必须把短路当成公共协议,监听器顺序也要有测试。事件名虽然能降低导入耦合,却会增加时序耦合;后者通常更难排查。

小结

DeepSeek Harness 选择 Cordis,解决的主要矛盾是 Agent 能力变化速度与运行时一致性之间的冲突。模型、工具、沙箱和 UI 都可以替换并不稀奇;这些能力可以在局部作用域内共存,能随依赖变化启停,能在配置失败后保留旧树,卸载时还能回收监听器、服务和子插件,才构成可用的插件架构。

它也没有抹平工程风险。Proxy 隐藏了查找路径,双层 scope 增加理解成本,热更新无法回滚任意外部副作用,预发布阶段也缺少跨版本兼容承诺。团队采用这套思路时,应复制它的生命周期纪律和能力边界,别只复制「一切皆插件」的目录结构。

源码给我们一些启发,把插件设计的评审顺序倒过来:先问如何撤销,再问如何注册;先证明局部挂载不会泄漏,再讨论全局复用;先定义失败后保留哪一棵树,再讨论热更新速度。做到这些,时空可组合才是一组可以验证的运行时语义。

这套架构个人理解是想往 Agent 的实时「自生长」,通过 AI 的能力在使用过程中让自己更强大。

逼逼这么多,主要还是在这个过程中学习一下,说实话,有了 DeepSeek Harness,想自己开发一个专属的 Agent ,快捷方便了很多,eg且这是 MIT 协议的。

以上。

参考资料


DeepSeek 和腾讯元宝都选择在用的SSE 到底是什么?

在我们和 AI 聊天中,AI Chat 都采用了一种「打字机」式效果的实时响应方式,AI 的回答逐字逐句地呈现在我们眼前。

在实现这个功能的技术方案选择上,不管是 DeepSeek ,还是腾讯元宝都在这个对话逻辑中选择了使用 SSE,如下面 4 张图:

这是为啥,它有什么优势,以及如何实现的。

SSE 的优势

因为它在该场景下的优势非常明显,主要是以下 4 点:

1.场景的高度匹配。

AI 对话的核心交互模式是:

  1. 用户发起一次请求(发送问题)。
  2. AI 进行一次持续的、单向的响应输出(生成回答)。

SSE 的单向通信(服务器 → 客户端)模型与这个场景高度切尔西。它就像一条专门为服务器向客户端输送数据的「单行道」,不多一分功能,也不少一毫关键。

相比之下,WebSocket 提供的是全双工通信,即客户端和服务器可以随时互相发送消息,这是一条「双向八车道高速公路」。为了实现 AI 的流式回答,我们只需要其中一个方向的车道,而另一方向的车道(客户端 → 服务器)在 AI 回答期间是闲置的。在这种场景下使用 WebSocket,无异于「杀鸡用牛刀」,引入了不必要的复杂性。用户的提问完全可以通过另一个独立的、常规的 HTTP POST 请求来完成,这让整个系统的架构更加清晰和解耦。

2.HTTP 原生支持,与生俱来的优势

SSE 是建立在标准 HTTP 协议之上的。这意味着:

  • 无需协议升级:SSE 连接的建立就是一个普通的 HTTP GET 请求,服务器以 Content-Type: text/event-stream 响应。而 WebSocket 则需要一个特殊的「协议升级」(Upgrade)握手过程,从 HTTP 切换到 ws:// 或 wss:// 协议,过程相对复杂。
  • 兼容性极佳:由于它就是 HTTP,所以它能天然地穿透现有的网络基础设施,包括防火墙、企业代理、负载均衡器等,几乎不会遇到兼容性问题。WebSocket 有时则会因为代理服务器不支持其协议升级而被阻断。并且云服务商对于 Websocket 的支持并不是很完善。
  • 实现轻量:无论是前端还是后端,实现 SSE 都非常简单。前端一个 EventSource API 即可搞定,后端也只需遵循简单的文本格式返回数据流。这大大降低了开发和维护的成本。

3.断网自动重连,原生容错

这是 SSE 的「王牌特性」,尤其在网络不稳定的移动端至关重要。

想象一下,当 AI 正在为我们生成一篇长文时,我们的手机网络突然从 Wi-Fi 切换到 5G,造成了瞬间的网络中断。

  • 如果使用 WebSocket:连接会断开,我们需要手动编写复杂的 JavaScript 代码来监听断开事件、设置定时器、尝试重连、并在重连成功后告知服务器从哪里继续,实现起来非常繁琐。
  • 如果使用 SSE:浏览器会自动处理这一切。EventSource API 在检测到连接中断后,会自动在几秒后(这个间隔可以通过 retry 字段由服务器建议)发起重连。更棒的是,它还会自动将最后收到的消息 id 通过 Last-Event-ID 请求头发送给服务器,让服务器可以从中断的地方继续推送数据,实现无缝的「断点续传」。当然,Last-Event-ID 的处理逻辑需要服务端来处理。

这种由浏览器原生提供的、可靠的容错机制,为我们省去了大量心力,并极大地提升了用户体验。

4. 易于调试

因为 SSE 的数据流是纯文本并通过标准 HTTP 传输,调试起来异常方便:

  • 我们可以直接在浏览器地址栏输入 SSE 端点的 URL,就能在页面上看到服务器推送的实时文本流。
  • 我偿可以使用任何 HTTP 调试工具,如 curl 命令行或者 Chrome 开发者工具的「网络」面板,清晰地看到每一次数据推送的内容。

而 WebSocket 的数据传输基于帧,格式更复杂,通常需要专门的工具来调试和分析。

使用 SSE 实现「打字机」效果

1.后端——调用大模型并开启「流式」开关

当后端服务器收到用户的问题后,它并不等待大语言模型生成完整的答案。相反,它在调用 LLM 的 API 时,会传递一个关键参数:stream=True。

这个参数告诉 LLM:「请不要等全部内容生成完再给我,而是每生成一小部分(通常是一个或几个‘词元’/Token),就立刻通过数据流发给我。」

下面是一个使用 Python 和 OpenAI API 的后端伪代码示例:

python

代码解读
复制代码
from flask import Flask, Response, request
import openai
import json

app = Flask(__name__)

# 假设 OpenAI 的 API Key 已经配置好
# openai.api_key = "YOUR_API_KEY"

@app.route('/chat-stream')
def chat_stream():
    prompt = request.args.get('prompt')

    def generate_events():
        try:
            # 关键:设置 stream=True
            response_stream = openai.ChatCompletion.create(
                model="gpt-4", # 或其他模型
                messages=[{"role": "user", "content": prompt}],
                stream=True 
            )

            # 遍历从大模型返回的数据流
            for chunk in response_stream:
                # 提取内容部分
                content = chunk.choices[0].delta.get('content', '')
                if content:
                    # 关键:将每个内容块封装成 SSE 格式并 yield 出去
                    # 使用 json.dumps 保证数据格式正确
                    sse_data = f"data: {json.dumps({'token': content})}\n\n"
                    yield sse_data

            # (可选) 发送一个结束信号
            yield "event: done\ndata: [STREAM_END]\n\n"

        except Exception as e:
            # 错误处理
            error_message = f"event: error\ndata: {json.dumps({'error': str(e)})}\n\n"
            yield error_message

    # 返回一个流式响应,并设置正确的 MIME 类型
    return Response(generate_events(), mimetype='text/event-stream')

if __name__ == '__main__':
    app.run(threaded=True)

在这段代码中,有几个关键点:

  1. stream=True:向 LLM 请求流式数据。
  2. 生成器函数(generate_events):使用 yield 关键字,每从 LLM 收到一小块数据,就立即将其处理成 SSE 格式(data: ...\n\n)并发送出去。
  3. Response(..., mimetype='text/event-stream'):告诉浏览器,这是一个 SSE 流,请保持连接并准备接收事件。
2.SSE 格式的约定

后端 yield 的每一条 data: 都像是一个个装着文字的信封,通过 HTTP 长连接这个管道持续不断地寄给前端。

前端收到的原始数据流看起来就像这样:

vbnet

代码解读
复制代码
data: {"token": "当"}

data: {"token": "然"}

data: {"token": ","}

data: {"token": "很"}

data: {"token": "乐"}

data: {"token": "意"}

data: {"token": "为"}

data: {"token": "您"}

data: {"token": "解"}

data: {"token": "答"}

data: {"token": "。"}

event: done
data: [STREAM_END]

看 DeepSeek 和腾讯元宝的数据格式,略有不同,不过有一点,都是直接用的 JSON 格式,且元宝的返回值相对冗余一些。 且都没有 data: 的前缀。

3.前端监听并拼接成「打字机」

前端的工作就是接收这些「信封」,拆开并把里面的文字一个个地追加到聊天框里。

html

代码解读
复制代码
<!-- HTML 结构 -->
<div id="chat-box"></div>
<input id="user-input" type="text">
<button onclick="sendMessage()">发送</button>

<script>
    let eventSource;

    function sendMessage() {
        const input = document.getElementById('user-input');
        const prompt = input.value;
        input.value = '';

        const chatBox = document.getElementById('chat-box');
        // 创建一个新的 p 标签来显示 AI 的回答
        const aiMessageElement = document.createElement('p');
        aiMessageElement.textContent = "AI: ";
        chatBox.appendChild(aiMessageElement);

        // 建立 SSE 连接
        eventSource = new EventSource(`/chat-stream?prompt=${encodeURIComponent(prompt)}`);

        // 监听 message 事件,这是接收所有 "data:" 字段的地方
        eventSource.onmessage = function(event) {
            // 解析 JSON 字符串
            const data = JSON.parse(event.data);
            const token = data.token;

            if (token) {
                // 将新收到的文字追加到 p 标签末尾
                aiMessageElement.textContent += token;
            }
        };

        // 监听自定义的 done 事件,表示数据流结束
        eventSource.addEventListener('done', function(event) {
            console.log('Stream finished:', event.data);
            // 关闭连接,释放资源
            eventSource.close();
        });

        // 监听错误
        eventSource.onerror = function(err) {
            console.error("EventSource failed:", err);
            aiMessageElement.textContent += " [出现错误,连接已断开]";
            eventSource.close();
        };
    }
</script>

这段代码主要有如下的点:

  1. new EventSource(...):发起连接。
  2. eventSource.onmessage:这是主要的处理函数。每当收到一条 data: 消息,它就会被触发。
  3. aiMessageElement.textContent += token;:这就是「打字机」效果的精髓所在——持续地在同一个 DOM 元素上追加内容,而不是创建新的元素。
  4. eventSource.close():在接收到结束信号或发生错误后,务必关闭连接,以避免不必要的资源占用。

EventSource 的来源与发展

在 SSE 标准化之前,Web 的基础是 HTTP 的请求-响应模型:客户端发起请求,服务器给予响应,然后连接关闭。这种模式无法满足服务器主动向客户端推送信息的需求。为了突破这一限制,开发者们创造了多种「模拟」实时通信的技术。

  1. 短轮询:这是最简单直接的方法。客户端通过 JavaScript 定时(如每隔几秒)向服务器发送一次 HTTP 请求,询问是否有新数据。无论有无更新,服务器都会立即返回响应。这种方式实现简单,但缺点显而易见:存在大量无效请求,实时性差,并且对服务器造成了巨大的负载压力。
  2. 长轮询:为了改进短轮询,长轮询应运而生。客户端发送一个请求后,服务器并不会立即响应,而是会保持连接打开,直到有新数据产生或者连接超时。一旦服务器发送了数据并关闭了连接,客户端会立即发起一个新的长轮询请求。这大大减少了无效请求,提高了数据的实时性,但仍然存在 HTTP 连接的开销,并且实现起来相对复杂。
  3. Comet:一个时代的统称:在 HTML5 标准化之前,像长轮询和 HTTP 流(HTTP Streaming)这样的技术被统称为 Comet。 Comet 是一种设计模式,它描述了使用原生 HTTP 协议在服务器和浏览器之间实现持续、双向交互的多种技术集合。 它是对实现实时 Web 应用的早期探索,为后来更成熟的标准化技术(如 SSE 和 WebSockets)奠定了基础。

随着 Web 应用对实时性要求的日益增长,需要一种更高效、更标准的解决方案。

  • WHATWG 的早期工作:SSE 机制最早由 Ian Hickson 作为「WHATWG Web Applications 1.0」提案的一部分,于 2004 年开始进行规范制定。
  • Opera 的先行实践:2006 年 9 月,Opera 浏览器在一项名为“Server-Sent Events”的功能中,率先实验性地实现了这项技术,展示了其可行性。
  • HTML5 标准化:最终,SSE 作为 HTML5 标准的一部分被正式确立。它通过定义一种名为 text/event-stream 的 MIME 类型,让服务器可以通过一个持久化的 HTTP 连接向客户端发送事件流。 客户端一旦与服务器建立连接,就会保持该连接打开,持续接收服务器发送的数据。

SSE 的本质是利用了 HTTP 的流信息机制。服务器向客户端声明接下来要发送的是一个数据流,而不是一次性的数据包,从而实现了一种用时很长的「下载」过程,服务器得以在此期间不断推送新数据。

其返回内容标准大概如下:

event-source 必须编码成 utf8 的格式,消息的每个字段都是用”\n”来做分割,下面 4 个规范定义好的字段:

  1. Event: 事件类型
  2. Data: 发送的数据
  3. ID:每一条事件流的ID
  4. Retry: 告知浏览器在所有的连接丢失之后重新开启新的连接等待的事件,在自动重连连接的过程中,之前收到的最后一个事件流ID会被发送到服务器

在实际中,大概率不一定按这个标准来实现。对于一些重连的逻辑需要自行实现。

现在大部分的浏览器都兼容这个特性,如图:

参考资料:

  1. en.wikipedia.org/wiki/Server…
  2. learn.microsoft.com/zh-cn/azure…
  3. www.cnblogs.com/openmind-in…
  4. javascript.ruanyifeng.com/htmlapi/eve…

以上。

这句话 DeepSeek 一定和你说过

春节期间,DeepSeek 的相关信息铺天盖地。从应用场景到实战演练,从论文解读到原理分析,从行业发展到国际局势,各路神仙各有观点,应接不暇,都看不完了。

我自己也深度使用了,包括文章撰写和代码输出,说实话,思考的过程确实惊艳了我。它的思考逻辑比我更完善,推导路径也更显性。

但今天我们聊的不是这些「高光时刻」,而是我们在实际使用过程中常常遇到的不可用场景:

“服务器繁忙,请稍后再试。”

是的,DeepSeek 的繁忙(也可以叫故障?)提示几乎成了高频词。无论是免费用户还是付费 API 调用者,都可能在关键时刻遭遇「空文本返回」、「响应超时」、「重试多次仍异常」等问题。

1. DeepSeek 的可用性表现

首先我们看一下官方的记录: https://status.deepseek.com/

总结起来如下:

  • 网页/API 性能异常(Web/API Degraded Performance)
    • 持续时间: 2025 年 1 月 27 日至今(2 月 5 日仍在监控中)
    • 影响范围: API 和网页服务同时出现性能下降,部分用户请求超时或失败。从实际使用体验来看,基本属于不可用的状态了,但是官方的状态还是可用,仅性能问题,这里的状态指标和实际还是有一些出入。
  • API 持续故障(Major outage/Partial outage):
    • 持续时间:2025 年 1 月 27 日到 2 月 5 日
    • 影响范围:持续影响 API 调用,故障持续时间较长,作为一个付费的能力,这是不合格的。
  • 网页对话服务不间断故障:
    • 持续时间:2025 年 1 月 27 日到 1 月 31 日
    • 影响范围:持续影响网页用户的使用,在用户的反馈中

从结果来看,DeepSeek 还没有做好应对海量用户的情况,不管是从资源部署,还是工程建设方面,都不是一个合格的状态。

在写这篇文章的时候,除了第一次正常返回,后续都是「服务器繁忙,请稍后再试。」 如下图所示:

图片

从用户能看到的表象来看,自 2025 年 1 月底至 2 月初,DeepSeek 多次出现服务中断:

  • 深度思考与联网搜索功能失效:用户使用核心功能时频繁提示「技术原因暂不可用」,仅保留基础对话能力。
  • API 服务波动:付费用户调用接口时返回空文本或延迟异常,甚至因「服务器资源紧张」暂停充值。
  • 注册与登录拥堵:因恶意攻击导致注册功能瘫痪。

DeepSeek 官方将问题归因于突发流量、系统升级适配、底层基础设施波动,并强调「稳定性是首要任务」。但用户更直观的感受是:服务可用性不足,容错机制缺失。

2. AIGC 产品和互联网产品的天然差异

DeepSeek 作为一个 AIGC 的产品,其和传统的互联网产品就存在天然的差异:

2.1 响应时间与计算资源消耗

传统互联网产品

  • 主要依赖数据库查询、预定义的业务逻辑和缓存,响应时间通常较短,且可预测。
  • 计算资源需求相对稳定,系统可扩展性较强。

AIGC 产品

  • 依赖深度学习模型进行推理,计算量大,响应时间较传统产品长,且可能因模型复杂度、输入长度等因素波动。
  • 需要强大的 GPU 计算资源,服务器负载高,可能导致响应延迟或服务不可用。
  • 可能需要异步处理或流式输出(如 ChatGPT 的逐字生成),以改善用户体验。

2.2 可靠性与稳定性

传统互联网产品

  • 由于功能是规则驱动的,系统行为可预测,崩溃或异常情况较少。
  • 依赖负载均衡、CDN、数据库复制等机制,保障高可用性(通常可达 99.99% 以上)。

AIGC 产品

  • 生成式AI的输出不确定,在不同运行环境、不同模型版本下可能产生不同结果,影响用户体验的一致性。
  • 可能受到模型崩溃、推理失败、内存爆炸、API 速率限制等问题的影响,导致服务不可用或部分功能异常。
  • 需要额外的故障检测、自动重试、回退机制(如降级到预定义模板或缓存内容)来提升系统可用性。

2.3 可控性与一致性

传统互联网产品

  • 业务逻辑是确定性的,相同输入通常会产生相同输出,保证用户体验的一致性。虽然有「千人千面」的算法,但是其本质上是可控的
  • 开发人员可以精确控制系统行为,便于调试和优化。

AIGC 产品

  • AI 生成内容的不可预测性导致相同输入可能产生不同的输出,影响可控性和一致性。
  • 需要温度参数(Temperature)、Top-K 采样等技术来调整生成稳定性,但仍无法完全保证一致性。
  • 可能需要缓存机制、提示词优化(Prompt Engineering)或微调模型来提高可控性。

2.4 可扩展性

传统互联网产品

  • 主要依赖水平扩展(如增加服务器、数据库分片)来提升性能。
  • 由于业务逻辑固定,扩展后的系统可保持较高的一致性。

AIGC 产品

  • 由于深度学习推理的计算密集型特性,水平扩展难度较高,需要依赖专用硬件(如 GPU)。
  • 高并发场景下,可能需要分布式推理、模型量化、边缘计算等优化策略来提升可扩展性。
  • 可能采用多级缓存(如存储常见问题的预生成答案,在产品中是否能使用待确认)来减少推理开销。

2.5 错误处理与恢复机制

传统互联网产品

  • 由于逻辑清晰,错误通常可以通过日志分析、异常处理机制快速排查和修复。
  • 具备回滚机制,当系统发生故障时,可以回退到稳定版本。

AIGC 产品

  • 由于模型的黑箱特性,错误较难追踪。
  • 可能需要人机协同(Human-in-the-loop)机制,让人工审核关键任务的生成内容。
  • 需要自动调整机制(如 RAG,Retrieval-Augmented Generation),结合外部知识库提高准确性。

2.6 可维护性与升级

传统互联网产品

  • 代码和数据库可以模块化升级,通常只影响部分功能。
  • 版本管理清晰,可通过灰度发布、A/B 测试等方式进行平滑更新。

AIGC 产品

  • 模型升级可能导致行为变化,新模型可能生成完全不同的内容,影响可用性。
  • 需要持续微调(Fine-tuning)或增强检索(RAG),以适应新需求。
  • 可能需要模型版本管理(如 OpenAI API 的 GPT-4.0 vs. GPT-3.5),让用户可选择不同模型版本,以保证兼容性。

AIGC 产品在系统可用性上面临更大的挑战,主要在于响应时间、可靠性、可控性和错误处理等方面。为了提升可用性,需要结合缓存优化、模型优化、人工审核、错误监测、版本管理等策略,从而确保系统的高效性和稳定性。

3. 借鉴传统互联网产品的可用性策略

在面对 DeepSeek 这样 AIGC 产品的可用性挑战时,我们可以借鉴传统互联网产品的高可用性策略。以下是三种核心策略:隔离、限流和弹性扩展,它们对于提升整体服务的稳定性和可靠性至关重要。

3.1 隔离

隔离 是指将不同类型的流量、服务和资源进行物理或逻辑上的分离,以减少单点故障的影响,提高系统的稳定性。

(1)传统互联网产品的隔离策略

  • 数据库读写分离:使用主从数据库架构,将读请求和写请求分离,提高数据库吞吐能力。
  • 微服务架构:将不同的业务模块拆分为独立的微服务,避免单个模块的故障影响整个系统。
  • 多数据中心部署:在不同地域部署多个数据中心,确保某个数据中心故障时,服务仍然可用。

(2)AIGC 产品中的隔离策略

  • 模型推理服务隔离:不同的 AI 任务(如文本生成、代码补全、图像生成)使用独立的推理服务,以避免相互影响。
  • 缓存与实时推理分离:对于常见问题或高频请求,使用缓存存储预生成的答案,减少对 AI 推理的依赖。
  • 免费用户和付费用户隔离:将高优先级的计算资源分配给付费用户,确保他们在高负载时仍能获得稳定的服务。
  • 企业用户和个人用户隔离:针对企业用户的部署资源和个人用户的资源做隔离,甚至对于企业用户做多个隔离泳道。

(3)隔离策略解决的问题

  • 减少单点故障,避免某个服务异常影响整个系统。
  • 优化资源利用,确保高优先级任务不会被低优先级任务拖累。
  • 提高系统韧性,即使部分服务故障,核心功能仍可正常运行。

(4)隔离策略的注意事项

  • 隔离的粒度需要合理设计,过度拆分可能导致管理复杂度上升,系统之间的通信成本增加。
  • 监控与调度,确保不同隔离层的资源调度合理,避免出现某些区域资源过载,而其他区域资源空闲的情况。

3.2 限流

限流 是指在高并发情况下,对请求进行限制,以防止系统过载,保障关键用户和服务的稳定性。

(1)传统互联网产品的限流策略

  • 令牌桶/漏桶算法:限制请求速率,确保系统不会被短时间内的流量高峰压垮。
  • IP 级限流:对单个 IP 地址的请求频率进行限制,防止恶意爬虫或 DDoS 攻击。
  • 用户级限流:根据用户级别(普通用户、VIP 用户)设置不同的 QPS 上限。

(2)AIGC 产品中的限流策略

  • API 访问限流:对于 DeepSeek 这样的 AI API,限制每个用户的最大请求频率,防止个别用户占用过多计算资源。以及对于 IP 的访问限流。
  • 任务队列管理:对于高计算消耗的任务(如长文本生成、复杂代码推理),采用任务排队机制,避免瞬时请求超载。排队机制在文生图的场景下属于通用方案,以 MJ 为例,其商业模式就在于任务数,任务能力的不同,底层还是资源的不同。
  • 用户限流:以某种代币的方式发放给免费用户,使其有一定的使用次数限制,增加浏览器指纹等用户级的限制,减少用户的并发使用情况,以及增加对话数的限制等。
  • 动态限流:根据服务器的当前负载自动调整限流策略,在资源紧张时降低 QPS,在资源充足时放宽限制。

(3)限流策略解决的问题

  • 防止系统崩溃,确保 AI 服务在高并发情况下仍能稳定运行。
  • 优化资源分配,优先保证高价值用户的服务体验。
  • 抵御恶意攻击,防止 DDoS 攻击或恶意爬取 API 造成的资源滥用。

(4)限流策略的注意事项

  • 限流策略需要动态调整,不能一刀切,否则可能导致正常用户体验下降。
  • 需要提供合理的错误反馈,例如「当前请求过多,请稍后重试」而不是简单的「服务器错误」。
  • 与缓存结合使用,对于常见请求,优先返回缓存结果,减少对 AI 推理的调用次数。这个点在产品层面需要考虑,确实,和传统互联网产品相比,缓存在 AIGC 产品中的使用需要更谨慎一些。

3.3. 弹性扩展

弹性扩展 是指根据实际流量动态调整计算资源,以提高系统的可用性和响应速度。

(1)传统互联网产品的弹性扩展策略

  • 自动扩容:使用云计算(如 AWS Auto Scaling、Kubernetes HPA)自动增加或减少服务器实例。
  • 负载均衡:使用 Nginx、CDN、反向代理等技术,将流量均匀分配到不同的服务器节点上。
  • 冷/热数据分离:将访问频率高的数据放入高速缓存,减少数据库查询压力。

(2)AIGC 产品中的弹性扩展策略

  • GPU 资源动态调度:由于 AI 推理高度依赖 GPU,可以采用动态 GPU 分配策略,根据请求量调整 GPU 负载。
  • 多模型并行推理:对于高负载场景,可以部署多个副本的 AI 模型,采用负载均衡策略分配请求。
  • 推理任务分批处理:对于大规模生成任务,采用批处理方式,提高计算效率,减少单次推理的成本。

(3)弹性扩展策略解决的问题

  • 避免资源浪费,在低流量时减少计算资源,降低运营成本。
  • 提升系统吞吐能力,在高流量时快速扩展计算能力,确保服务稳定。
  • 提升响应速度,减少高并发情况下的请求排队时间,提高用户体验。

(4)弹性扩展策略的注意事项

  • 扩容速度需要优化,如果扩容响应过慢,可能导致短时间内大量请求失败。
  • 成本控制,GPU 计算资源昂贵,需要权衡服务质量与成本。
  • 监控与预警,需要实时监控系统负载,提前预测流量高峰,避免突发情况导致系统崩溃。

AIGC 更多的问题还是算力资源的问题,从 DeepSeek 的服务器 IP 来看,其使用的是华为云,后端推理算力不确定是哪家的。基于多云的弹性调度是一个可以考虑的方案,当然,前提是成本能够扛得住。

4. 从故障看 AIGC 可用性策略的四大核心矛盾

  1. 算力需求与资源调度的失衡
    AIGC 模型的推理成本极高。当用户量激增或遭遇攻击时,弹性伸缩能力不足可能直接导致服务崩溃。

  2. 功能复杂度与稳定性的博弈
    DeepSeek 的「深度思考」依赖多模态数据处理和强化学习技术,但功能越复杂,系统耦合性越高,单点故障风险越大。

  3. 用户预期与容灾能力的落差
    用户对 AIGC 的期待是「类人级响应」,但实际服务常因网络抖动、模型加载延迟等问题降级为「机械式回复」。

  4. 商业化压力与技术投入的冲突
    尽管 DeepSeek 登顶多国应用商店榜单,但其快速扩张可能透支了技术团队的运维能力,导致故障频发后被迫暂停 API 充值。

DeepSeek 的故障并非个例,而是 AIGC 行业集体面临的挑战。从技术角度看,模型能力与系统稳定性需同步进化;从用户角度看,容忍度与预期管理同样关键。

未来,AIGC 服务的竞争不仅是「谁更聪明」,更是「谁更可靠」,特别是在企业应用的场景。毕竟,再惊艳的思考过程,若总以「服务器繁忙」收场,终将消磨用户的耐心与信任。

以上。